¿Qué es un generador de frases con cadena de Markov?
Una explicación sencilla de estados, probabilidades de transición, corpus de texto y diferencias prácticas frente a las herramientas de IA.
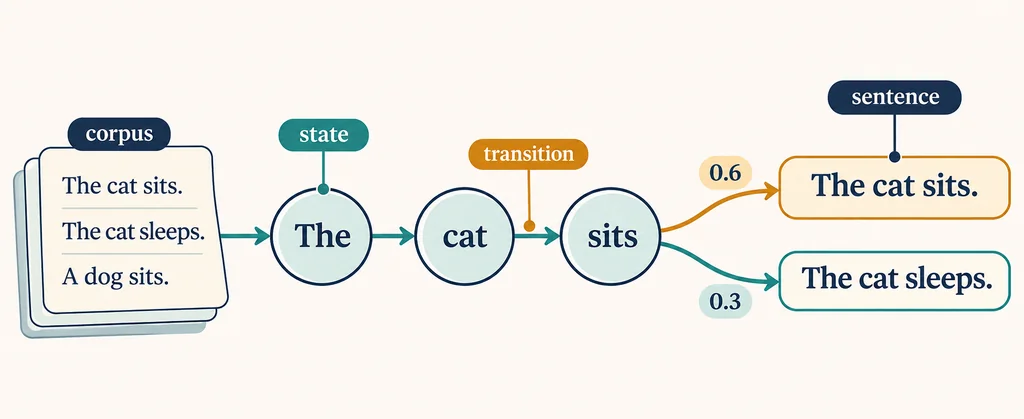
El modelo Markov elige la siguiente palabra a partir de transiciones aprendidas de un corpus.
En esta página
Si buscas un generador de frases con cadena de Markov, es posible que encuentres un repositorio, una biblioteca de Python o una pequeña demo que produce texto aparentemente legible. Esos resultados son interesantes, pero suelen dar por hecho que sabes qué es un estado y por qué el texto de entrada cambia la salida. Esta guía empieza por esa parte. Explica cómo un corpus se convierte en transiciones con peso, muestra un ejemplo y compara el método con un generador de frases con IA. El objetivo no es prometer prosa perfecta, sino ayudarte a elegir el método que corresponde a tu tarea.
¿Qué es un generador de frases con cadena de Markov?
Una cadena de Markov es un modelo que describe el paso entre estados. En un generador de frases, un estado puede ser una palabra, un par de palabras o una secuencia más larga. El modelo registra qué suele venir después de cada estado en el texto de entrenamiento. Al generar, elige el siguiente estado según las frecuencias observadas y repite el proceso hasta encontrar un final.
La cadena es local y no semántica. Si el corpus contiene muchas veces “el gato duerme”, el modelo aprende vecinos para el, gato y duerme. No sabe que un gato es un animal, que dormir es una acción ni que la frase sea verdadera. El resultado puede sonar familiar porque sigue patrones de la fuente aunque la idea completa sea extraña.
Por eso, un generador de frases con cadena de Markov se entiende mejor como un muestreador estadístico. Recombina piezas de un corpus elegido, en vez de escribir desde un modelo del mundo. El orden de la cadena, la limpieza del corpus y las reglas de inicio y final influyen más en la calidad que el nombre del producto.
Definición práctica
La generación Markov predice una palabra usando una historia reciente y limitada. Puede imitar ritmo y estilo local, pero no comprueba hechos, no sigue instrucciones largas y no garantiza una idea completa.
Cómo los estados y las transiciones crean texto
El mismo proceso de cuatro etapas explica la mayoría de los generadores de texto Markov. Puedes implementarlo con una biblioteca como Markovify o con una tabla sencilla de conteos, pero la lógica es la misma.
1. Construir una tabla de estados
Divide el corpus en frases y tokens, y cuenta los estados que aparecen. Con tamaño uno, el estado es una sola palabra. Con tamaño dos, recuerda un par como “el gato”. Un estado grande conserva más contexto local, pero necesita más ejemplos.
2. Contar transiciones
Para cada estado, registra las palabras o estados que le siguen. Si “el gato” va seguido de “duerme” seis veces y de “corre” dos, el generador convierte esos conteos en probabilidades. Son probabilidades condicionadas: describen qué sigue a ese estado, no qué palabra es más común en general.
3. Elegir un comienzo
Una frase necesita un marcador de inicio o una lista de estados iniciales válidos. Las bibliotecas que conservan límites de frase evitan empezar a mitad de una cláusula. Si el corpus se carga como una sola línea, puede no haber comienzos ni finales confiables.
4. Muestrear una transición cada vez
El generador elige una palabra, la añade y usa el nuevo final para elegir otra. Dos ejecuciones pueden diferir con el mismo modelo porque hay azar. Una semilla permite repetir un experimento, pero no añade comprensión del lenguaje.
5. Detener y filtrar
La cadena termina en un marcador final, un límite de longitud o cuando no encuentra una continuación válida. Algunas bibliotecas rechazan textos demasiado parecidos a la fuente, demasiado largos o con puntuación rota. Esos filtros mejoran la presentación, no el significado.
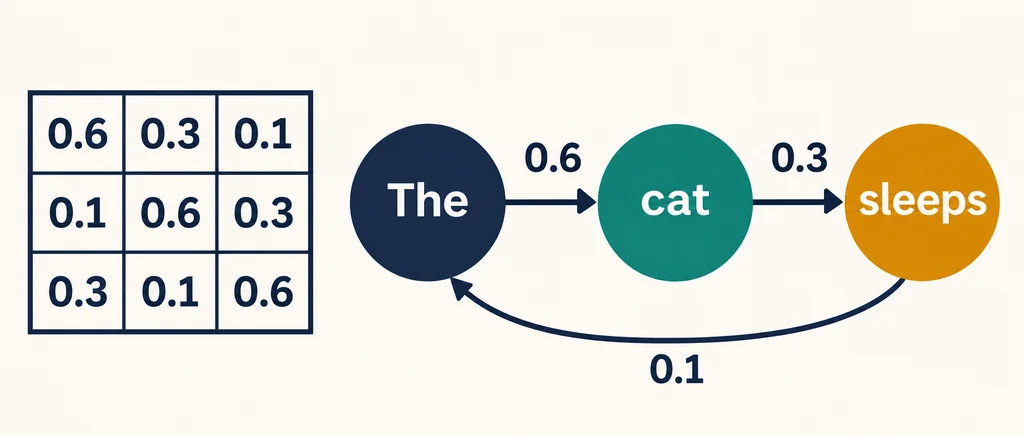
Modelo mental útil
Lee cada resultado como un camino por un grafo. El camino puede parecer probable paso a paso aunque el destino completo sea inesperado.
Un ejemplo pequeño de frase
Imagina un corpus con tres frases: “The cat sleeps”, “The cat watches birds” y “The dog sleeps”. Un modelo de una palabra ve vecinos frecuentes; uno de dos palabras conserva más contexto. La tabla es simplificada, pero muestra que la siguiente palabra es una elección probabilística.
| Estado actual | Siguiente estado | Probabilidad ilustrativa | Salida posible |
|---|---|---|---|
| The | cat / dog | 0,67 / 0,33 | The cat… o The dog… |
| The cat | sleeps / watches | 0,50 / 0,50 | The cat sleeps… |
| The dog | sleeps | 1,00 | The dog sleeps. |
| cat watches | birds | 1,00 | cat watches birds. |
| sleeps | marcador final | 1,00 | Cerrar la frase. |
Los números son ilustrativos, no una prueba de rendimiento. Un modelo real puede usar más frases, tokens de puntuación, suavizado, filtros de repetición y un tamaño de estado mayor. Lo esencial es que el generador sigue la evidencia del corpus y no prepara un tema antes de empezar.
Por qué importa el corpus de origen
Un modelo Markov solo puede contar las transiciones que aparecen en su texto. Aquí “entrenar” significa construir una tabla a partir de ejemplos, no aprender una representación general del idioma. Antes de juzgar la salida, revisa qué datos recibió.
- Tamaño — Unas pocas frases crean un grafo estrecho con muchos callejones sin salida. Un corpus mayor ofrece más transiciones y reduce algunas repeticiones, aunque más texto no significa automáticamente mejor escritura.
- Coherencia — Un corpus sobre un tema o una voz produce un estilo más estable. Mezclar manuales, bromas y comentarios sin relación crea transiciones gramaticales en lo local pero confusas en conjunto.
- Puntuación — Los límites de frase, las mayúsculas y las comillas ayudan a encontrar comienzos y finales. La puntuación sucia puede filtrar fragmentos, signos duplicados o salidas demasiado largas.
- Tamaño de estado — Un estado de dos o tres palabras conserva frases cortas mejor que uno de una palabra, pero necesita más ejemplos para cada combinación. Con pocos datos, un estado grande puede hacer que falle.
- Sesgo y propiedad — El generador puede repetir estereotipos, datos privados o expresiones distintivas del corpus. Usa texto que tengas derecho a procesar, elimina información sensible y revisa las coincidencias reconocibles.
Para experimentar, cambia una variable cada vez: conserva el corpus y compara tamaños de estado, o conserva el tamaño y compara dos corpus. Así podrás ver el efecto de la cadena sin confundirlo con un cambio de datos.
Cadena de Markov frente a un generador de frases con IA
Ambos sistemas pueden producir una frase nueva, pero resuelven problemas diferentes. Una cadena de Markov es un muestreador transparente de estados. Un generador de frases con IA usa un modelo neuronal entrenado que puede atender instrucciones, contexto y una distribución lingüística más amplia. Ninguna etiqueta elimina la revisión.
| Dimensión | Modelo Markov | Generador con IA | Mejor opción |
|---|---|---|---|
| Entrada | Corpus local y límites de tokens | Prompt, contexto y una indicación de estilo | Markov para experimentar; IA para una tarea guiada. |
| Proceso | Cuenta transiciones y muestrea paso a paso | Predice tokens con un modelo neuronal grande | Markov cuando necesitas inspeccionar el mecanismo. |
| Control | Control del corpus, estado y filtros | Controles mediante prompts y opciones del producto | Elige lo que puedas probar con claridad. |
| Coherencia | Buen ritmo local, poca planificación larga | Mejor contexto y objetivo de varias frases | IA para un borrador; verifica los hechos. |
| Coste y privacidad | Puede ejecutarse localmente | Puede enviar texto a un servicio y tener límites | Lee la política antes de subir información sensible. |
Llamar “IA” a cualquier texto aleatorio oculta la diferencia entre un modelo estadístico pequeño y un sistema neuronal. Nombrar el mecanismo ayuda a entender sus controles, resultados y riesgos.
Cuándo resulta útil la generación Markov
Un generador de frases con cadena de Markov encaja cuando el experimento necesita transparencia, estilo local o ejecución sin conexión. No es la mejor opción cuando la salida debe ser factual, razonada o publicable sin edición.
- Enseñar probabilidad — Los estudiantes pueden contar transiciones, dibujar un grafo y observar cómo una frecuencia cambia la siguiente palabra.
- Prompts creativos — Un corpus controlado puede producir fragmentos sorprendentes para ideas, voz de personajes o juegos de escritura. Úsalos como disparadores, no como líneas terminadas.
- Prototipos — Los desarrolladores pueden probar una interfaz de generación, una semilla reproducible o una salida progresiva sin conectar un modelo alojado.
- Experimentos privados — Con el corpus local, la generación puede funcionar sin enviar cada prompt a una API externa. La privacidad depende de cómo se obtuvo y guardó el corpus.
- Inspeccionar estilo — Comparar corpus o tamaños de estado permite observar frases repetidas, longitudes y hábitos de transición.
Límites y uso responsable
El texto Markov puede sonar fluido durante unas palabras y aun así ser engañoso. Haz visibles sus límites cuando muestres una demo, publiques un experimento o uses el resultado en un producto.
- No comprueba el significado — El modelo no sabe si una afirmación es cierta, segura, actual o apropiada. Una secuencia natural puede incluir un dato falso.
- Memoria corta — Una cadena de primer o segundo orden olvida pronto el contexto. Nombres, condiciones y relaciones pueden cambiar después de varias transiciones.
- Repeticiones y fragmentos — Los corpus pequeños crean bucles, frases repetidas y finales bruscos. Los filtros ocultan algunos fallos, pero no sustituyen la revisión.
- Fuga del corpus — La salida puede repetir expresiones distintivas de la fuente. Texto nuevo no significa originalidad, permiso ni ausencia de obligaciones de atribución.
- Límites lingüísticos — La tokenización y el orden de palabras cambian entre idiomas. Un ejemplo en inglés no se traslada sin más al español, japonés, coreano o alemán.
En una página pública, etiqueta el resultado como generado, explica la fuente o el método y conserva una revisión antes de copiarlo en un correo, tarea, publicación o decisión.
Elige la herramienta de frases adecuada
Un generador de frases aleatorias sirve para obtener una idea rápida. Un generador de frases con cadena de Markov sirve para estudiar cómo un corpus da forma a las transiciones. Si ya tienes palabras o un borrador, una herramienta específica suele ser más directa que pedir a un modelo aleatorio que resuelva otra tarea.
Prueba Random Sentence Generator para inspiración, vuelve a la página principal para generar con IA cuando necesites contexto, o usa Sentence Generator from Words cuando partas de una lista de vocabulario. Conocer los límites te ayuda a revisar el resultado con expectativas realistas.
Preguntas frecuentes sobre el generador de frases con cadena de Markov
Resumen
Un generador de frases con cadena de Markov construye una tabla de transiciones desde un corpus, elige un estado inicial, muestrea una palabra cada vez y se detiene en un límite. El tamaño de estado, la puntuación, la calidad del corpus y los filtros deciden si el resultado es coherente o repetitivo.
Usa cadenas de Markov para experimentos transparentes, clases, prototipos sin conexión y prompts creativos controlados. Usa un generador de frases con IA cuando necesites instrucciones, contexto amplio o un borrador más completo, y revisa ambos tipos de salida.
Fuentes y lecturas adicionales
Estas referencias respaldan la diferencia entre un modelo de transiciones transparente, una implementación práctica y una explicación visual de las probabilidades.
- Markovify en GitHub — Generador de cadenas de Markov con ejemplos de texto y tamaño de estado
- Setosa Markov Chains — Explicación visual de estados, transiciones y matrices
- Markovipy — Repositorio con demo, uso y características de un generador de frases
Última actualización: 16 de noviembre de 2026